Eén user story, één agent-sessie, toegang tot elke service die de story raakt. Met de repo's naast elkaar in één map ziet één sessie alle services die de story raakt. In een monorepo geeft één Git worktree een agent bovendien de hele codebase op een eigen branch. Dan hoef jij geen context meer over te typen van de ene sessie naar de andere.
Voor wie? Developers en tech leads met services in meerdere repo's die AI-agents inzetten en merken dat elke story drie sessies kost.
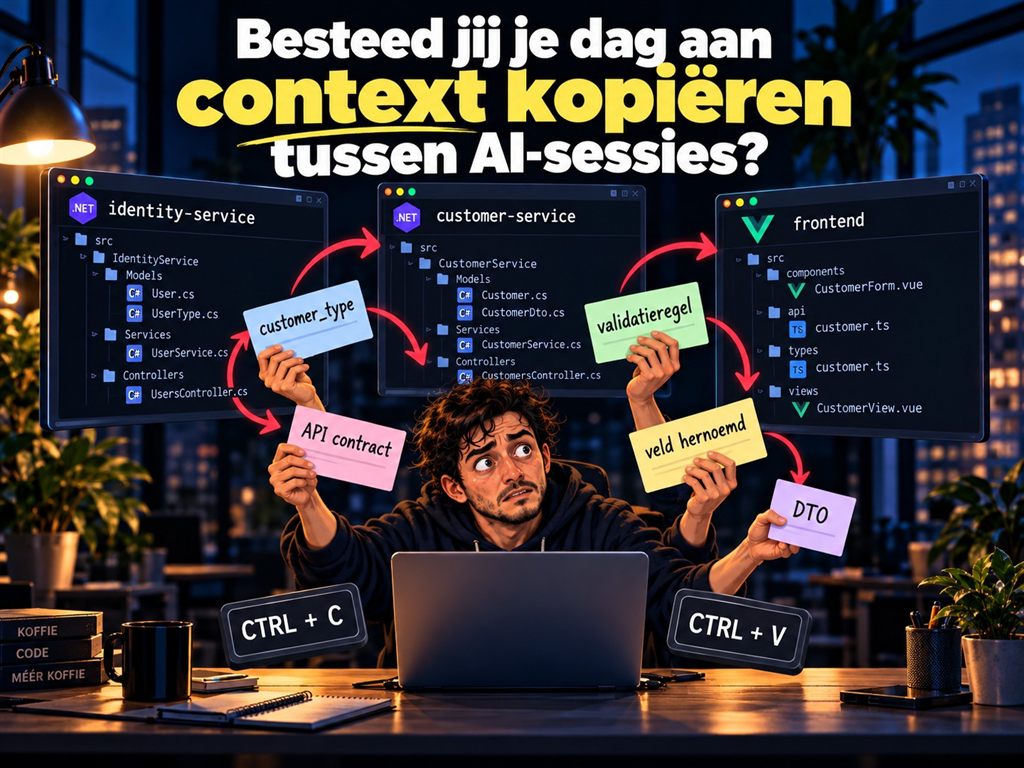
Ben jij de hele dag context aan het kopiëren tussen AI-sessies? Je agents delen geen context. Dus breng jij die rond, van sessie naar sessie, als een menselijk klembord.
- "Ik heb net dit veld aangepast in de identity service..."
- "Trouwens, dat veld heet in de customer service nu anders..."
- "Neem deze validatieregel ook mee naar de frontend..."
Elke nieuwe sessie typ je context over die je tien minuten eerder in de vorige had uitgezocht. Dat kost tijd en het is precies het werk waar fouten in sluipen.
Waarom word je zelf het klembord?
Omdat we agents inrichten zoals we zelf werken. Eén nieuw veld in mijn SaaS raakt de identity service, de customer service en de Vue-frontend. Als developer pak je dat stap voor stap aan. Dus doen we dat met agents ook zo: een repo openen, een sessie starten, een deel van de taak meegeven. Drie keer, drie sessies.
Elke sessie kent alleen zijn eigen repo. De naam van het veld, de validatieregel, de aanname over het datamodel: die kennis zit in de vorige sessie en in jouw hoofd. Jij wordt de koppeling tussen de services, terwijl de agent dat werk had kunnen doen.
Hoe werkt één sessie per user story?
Wat voor mij beter werkt: één user story, één agent-sessie, toegang tot elke service die de story raakt. De repo-indeling is een keuze over waar de code staat. Die hoort niet te bepalen hoe de agent werkt.
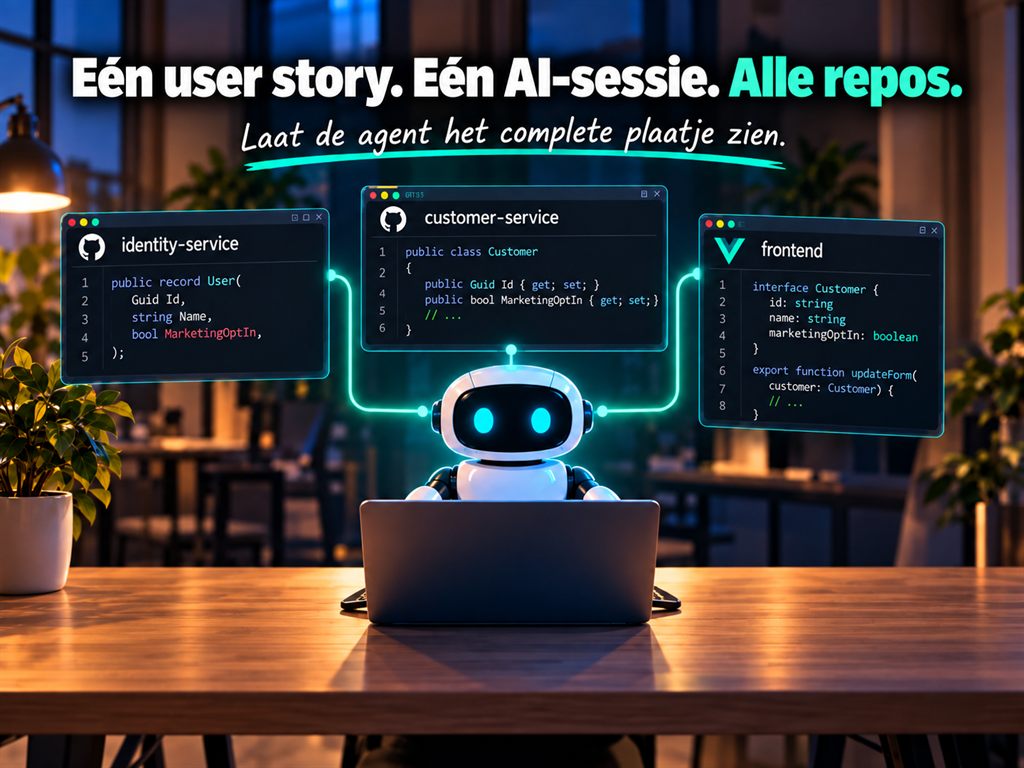
De volgorde blijft hetzelfde als bij goed handwerk. Ik laat de agent eerst de blast radius in kaart brengen: welke services, welke koppelvlakken, welke tests raakt deze story? Daarna schrijft hij één plan over alle services en pas dan bouwt hij. Reviews en tests blijven. Het verschil is dat de agent nu de koppelvlakken bewaakt en ik alleen nog het geheel beoordeel.
Parent folder: hoe start je één sessie over alle repo's?
De eenvoudigste stap: zet de repo's naast elkaar in één map en start de agent vanuit die bovenliggende map. In Claude Code en Codex kan de agent dan alle projecten lezen en aanpassen in één sessie. Elke repo houdt zijn eigen git-historie; de agent commit per repo.
Zo begon ik met mijn SaaS: 15 repositories, waaronder 12 microservices en een Vue-frontend. Eén veld toevoegen kostte me twee uur over negen lagen. Het werd één instructie, gevolgd door zo'n tien minuten review en een e2e-test.
De prijs van deze opzet zie je pas bij parallel werken. Wil je twee stories tegelijk laten lopen, dan heb je per story een aparte werkmap nodig, met daarin weer alle repo's. Bij vijftien repo's is dat snel gedoe.
Monorepo: wanneer zijn worktrees de betere stap?
Inmiddels heb ik mijn 15 repositories gemigreerd naar één monorepo. Daar komen Git worktrees tot hun recht. Een worktree is een extra werkmap van dezelfde repository, op een eigen branch, naast je gewone checkout. In een monorepo geeft één worktree een agent dus de hele codebase, geïsoleerd van jouw werk en van andere agents. Ik kan meerdere agents naast elkaar laten werken, elk aan een eigen story, zonder dat ze elkaars werkmap raken. Elke story eindigt als één branch en één PR over alle services heen.
Met losse repo's blijft één story meerdere PR's en meerdere deploys die je op elkaar moet afstemmen. In een monorepo is dat één review en één release. Voor wie meerdere agents tegelijk aanstuurt, scheelt dat het meeste schakelen.
Een monorepo heeft eigen kosten: langere CI-runs, eigenaarschap dat je opnieuw moet afspreken en deploys die je apart moet houden als niet alles tegelijk mag uitrollen. Ook een worktree kost iets: elke worktree heeft een eigen restore en build nodig, eigen poorten voor de dev-servers en soms een eigen database. Weeg dat af met je team. Raken de meeste stories maar één repo, dan is een sessie per repo gewoon rustiger.
De repo-indeling is hoe we de code hebben georganiseerd. Die hoort niet te bepalen hoe de agent werkt.
Wil je weten of dit voor jullie speelt, kijk dan naar de laatste vijf user stories. Hoeveel repo's raakte elke story? Bij één repo per story verandert er weinig. Bij drie of meer ben jij waarschijnlijk het klembord.
Hoe pak jij user stories aan die over repo's heen gaan: een sessie per repo, een parent folder of een monorepo met worktrees?