In het kort: je tests zijn groen, de demo klopt en toch kan klant A bij de data van klant B. In een multitenant platform is één query zonder filter op organisatie daarvoor genoeg. Je review vindt het niet, want een filter dat ontbreekt staat niet in de diff. Dwing de scheiding af op één centrale plek, test met twee organisaties en laat een secure code review doen door iemand die er niet zelf aan gebouwd heeft.
Voor wie? Developers, tech leads en CTO’s die met AI-agents een platform bouwen waarin meerdere klanten hun data in dezelfde applicatie hebben staan.
Je nieuwe platform is net live. Een klant belt. Hij kan de data van een andere klant inzien.
En je weet niet wie er nog meer bij kan.
Dit scenario is fictief. Het is wel het lek waar elk platform met meerdere klanten in één applicatie gevoelig voor is. Met agents die in een middag een compleet nieuw scherm bouwen, ontstaat het sneller dan vroeger.
Hoe ontstaat een multitenant datalek in AI-code?
Zo kan het gaan. Een agent bouwt een nieuw overzicht. Het werkt en de tests zijn allemaal groen.
Alleen ontbreekt in één query het filter op organisatie. Wie per ongeluk of expres een nummer in de adresbalk aanpast, ziet de data van een ander bedrijf. De agent van een klant heeft daar geen adresbalk voor nodig. Die roept je API rechtstreeks aan en probeert in een paar seconden honderd nummers.
Dit lek heet Broken Object Level Authorization, ook bekend als IDOR. Het staat op nummer 1 in de OWASP API Security Top 10 van 2023[1]. De gebruiker is netjes ingelogd. Niemand controleert of het object dat hij opvraagt ook van zijn organisatie is.
Een developer met haast maakt deze fout ook. Een agent levert alleen veel meer queries per dag op. Elke nieuwe query is een nieuwe kans om het filter te vergeten.
Waarom zie je het niet in een demo, een review of een test?
In een demo zie je dit niet. Je logt in als één klant en alles klopt.
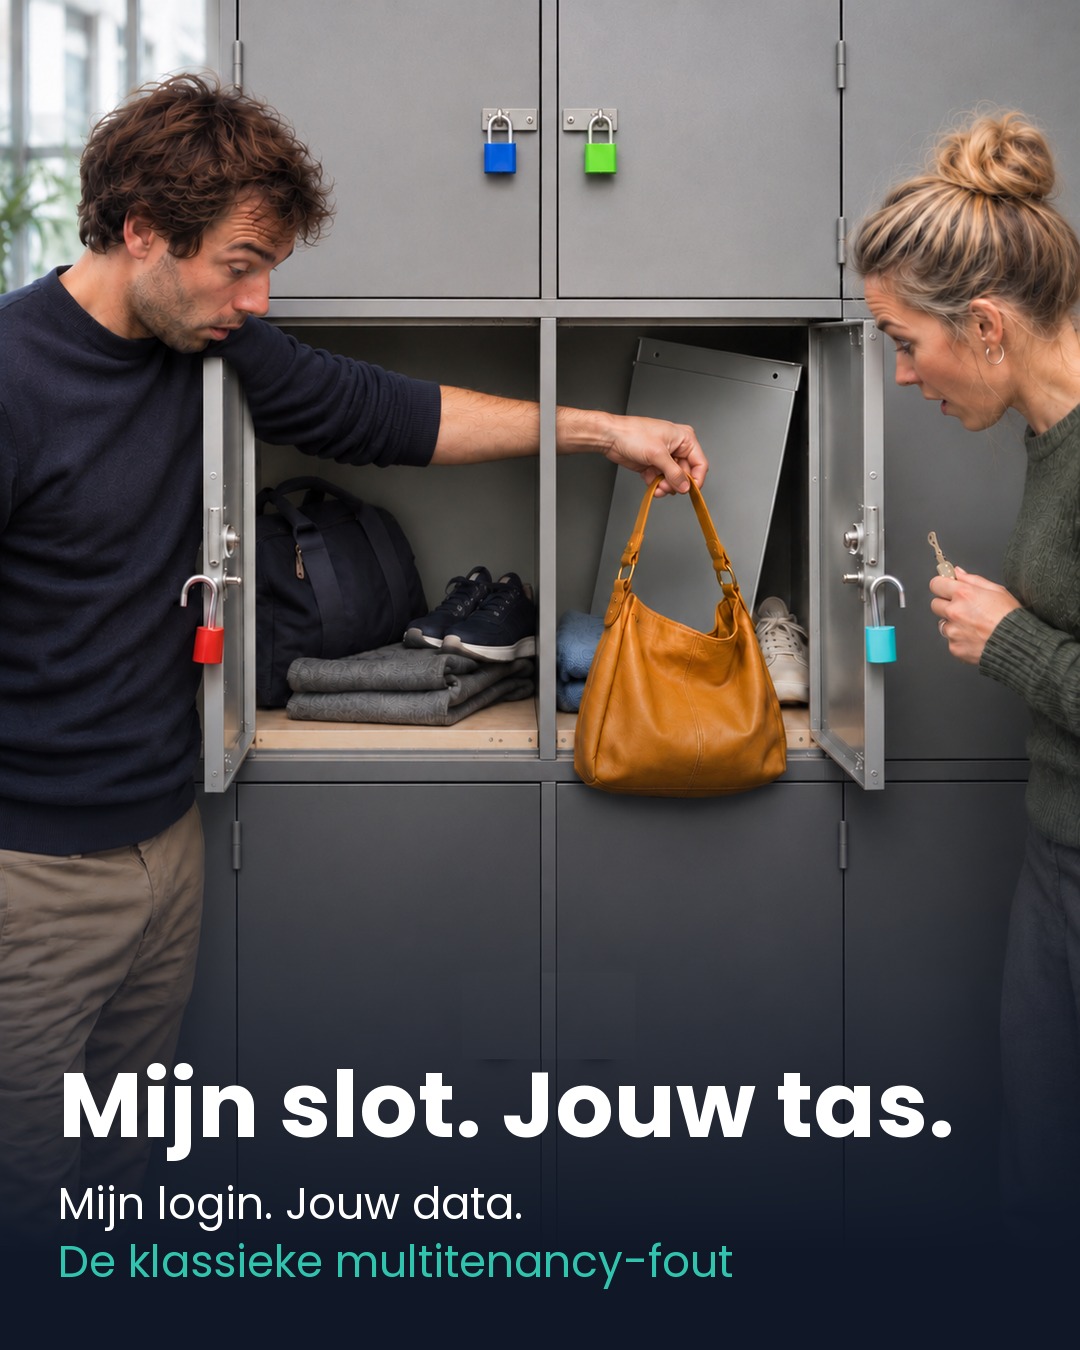
Het is als een wand kluisjes. Elke klant heeft een eigen slot op de deur. Maar als het schot tussen de kluisjes niet goed vastzit, kun je bij elkaars spullen.
De ervaren developer vertrouwt op zijn review. Maar een filter dat ontbreekt, staat niet in de diff. Een review laat zien wat er is toegevoegd. Het ontbrekende filter moet de reviewer er zelf bij bedenken.
De junior ziet groene tests en gaat door. Die tests draaien onder één testorganisatie. Met maar één organisatie in de testdata kan een test dit lek niet vinden. Dat groene tests alleen iets zeggen over de scenario’s die je hebt getest, beschreef ik eerder bij verification debt.
Wie zonder programmeerervaring bouwt, weet vaak niet eens dat dit risico bestaat.
Alle drie maken ze dezelfde denkfout. Het werkt, dus het zal wel goed zijn.
Waar dwing je de scheiding tussen klanten af?
Bouw de scheiding tussen klanten in je securitymodel in. Dwing die af op één centrale plek, bij lezen en bij schrijven. Bijvoorbeeld met een filter op organisatie dat automatisch op elke query zit. Dan hoeft niemand het telkens opnieuw toe te voegen, ook een agent niet.
In .NET kan dat met de global query filters van EF Core. Je legt het filter één keer vast op het entiteitstype en EF Core zet het daarna op elke query voor dat type[2]:
modelBuilder.Entity<Invoice>()
    .HasQueryFilter(i => i.TenantId == tenantId);
Ken wel de grenzen van zo’n filter:
- Met
IgnoreQueryFilters()zet je het voor één query uit. Handig voor een beheerscherm. Zoek bij elke review op die aanroep. - SQL die buiten EF Core om loopt, zoals een stored procedure of een query via Dapper, krijgt het filter niet mee.
- Het filter werkt op lezen. Bij een insert bepaalt je eigen code welke organisatie-id in het record komt.
Een tweede laag kan in de database zelf zitten. Row-level security in SQL Server filtert rijen bij lezen en blokkeert schrijfacties die de regel schenden, ook als de applicatie het filter vergeet[3]. Twee lagen kosten meer werk. Daar staat tegenover dat een vergeten filter in de applicatie dan niet meteen een lek is.
Leg de regel ook vast waar de agent hem leest. In de instructies in je repo hoort te staan hoe de scheiding tussen klanten werkt en dat een query zonder die scheiding niet door de review komt.
Hoe test je de scheiding met twee organisaties?
Test het met twee organisaties. Kan klant A de data van klant B lezen of wijzigen? Zet daarvoor een tweede organisatie in je testdata en vraag als klant A iets op dat van klant B is. Een fictief voorbeeld van zo’n test:
[Fact]
public async Task Invoice_from_another_tenant_returns_404()
{
    // Arrange: an invoice that belongs to tenant B
    var invoiceOfB = await CreateInvoiceFor(tenantB);

    // Act: tenant A requests it by id
    var client = ClientFor(tenantA);
    var response = await client.GetAsync($"/api/invoices/{invoiceOfB.Id}");

    // Assert: tenant A must not learn that it exists
    Assert.Equal(HttpStatusCode.NotFound, response.StatusCode);
}
Zo’n test kan op twee niveaus. Een unittest op de service met data van twee accounts is snel en vindt het vergeten filter. Een integratietest op de API vindt ook het endpoint dat de service omzeilt. De meeste dekking krijg je van één generieke test die alle endpoints langsloopt met een id van de andere organisatie.
Vergeet het schrijven niet. Een PUT of DELETE op een record van een andere organisatie hoort net zo hard te falen als een GET.
In mijn eigen SaaS-platform draaien zulke tests bij elke pull request mee. Tests met een tweede account staan in ongeveer twintig testbestanden. De pipeline draait ze als blokkerende stap. Bij een rode test faalt de build van de pull request. OWASP adviseert hetzelfde: schrijf tests voor je autorisatie en rol geen wijziging uit waarbij die tests falen[1].
Wanneer laat je een secure code review doen?
Laat daarnaast een secure code review doen die gericht kijkt naar de scheiding tussen klanten. Door iemand met securityervaring die er niet zelf aan gebouwd heeft.
Dat is iets anders dan een algemeen reviewrondje of een tweede ronde door je eigen agent. Wie het systeem gebouwd heeft, test de paden waar hij zelf aan gedacht heeft. Een buitenstaander stelt bij elk endpoint dezelfde vraag. Van wie is dit object en waar wordt dat gecontroleerd?
Het logische moment is voor de eerste livegang met meer dan één klant. Daarna bij elke grote wijziging in het datamodel of de autorisatie. Wie binnen het team verantwoordelijk blijft voor wat een agent oplevert, staat in wie is verantwoordelijk voor AI-code.
Is dit een risico dat je kunt accepteren?
Geen enkele controle vangt alles. De maatregelen uit dit artikel vullen elkaar aan. Er blijft altijd iets over dat je bewust accepteert.
Dit lek hoort daar niet bij. Klant A die bij de data van klant B kan, is een datalek. Zo’n risico is niet acceptabel.
Test jij met minstens twee organisaties?